为什么新闻/小说内容资讯采集难
新闻/小说内容资讯采集,最难的是“稳定拿到页面内容”
资讯与小说站点更新频繁、结构复杂,且普遍部署 Cloudflare 防护。采集过程中常遇到验证跳转、内容不完整、频控封锁与动态渲染等问题,导致数据缺失与同步延迟。
-
Cloudflare验证频繁拦截
五秒盾、JS质询、Turnstile反复触发,脚本容易直接失效。
-
章节更新难以持续追踪
目录与章节滚动更新,断更、漏采与重复采集问题高发。
-
动态渲染导致正文缺失
内容异步加载或分页拼接,抓到空壳HTML,难以结构化解析。
-
高并发易触发风控封禁
请求集中时触发限速与封锁,成功率波动大、稳定性不可控。
技术支持联系方式

用穿云API打通“新闻/小说内容资讯数据采集”的稳定链路
穿云API面向采集场景提供 Cloudflare 验证绕过能力,自动处理五秒盾、JS Challenge 与 Turnstile,减少人工干预与策略维护;并支持高并发调用,让内容抓取、解析与同步更稳定。
-
自动绕过五秒盾
无需处理挑战页面逻辑,稳定解锁后直接返回目标页面内容,提升采集成功率
-
支持JS Challenge
自动应对 Cloudflare JS 质询与跳转流程,减少脚本适配与维护成本。
-
兼容Turnstile
支持处理 Turnstile 等人机验证场景,降低采集链路中断概率,保障持续更新。
-
高并发稳定直出
面向批量采集任务优化并发能力,请求返回网页源码,便于直接解析入库。
适用场景
适用于新闻/小说内容资讯数据采集需要绕过 Cloudflare 等验证机制,实现稳定数据采集的网页
热点资讯聚合采集与去重
面向多资讯源的栏目与专题页,持续拉取最新内容并进行相似去重,形成统一的热点时间线与事件库,便于搜索、推荐与舆情监控快速消费数据。
小说目录与章节增量同步
针对目录页与章节页的连续更新,按更新时间或章节序号进行增量抓取与断点续采,避免漏采与重复采集,保障长链路内容同步稳定运行。
内容详情页结构化抽取入库
面向正文页、章节页与评论区页面,将标题、正文段落、作者信息、发布时间等内容抽取为统一结构,便于后续建模、检索与内容运营分析。
榜单与频道更新监控
对“热榜/最新/推荐/分类频道”等入口页面进行定时采集,监控排名变化与更新频率,捕捉内容趋势与平台运营节奏,为选题和推荐策略提供依据。
跨站点内容对标与转载追踪
针对同一事件或同一作品在不同站点的发布差异,采集多来源版本进行对比追踪,识别转载链路、发布时间差与内容改写情况,提升分析可靠性。
大规模采集任务调度与回补
支持任务按队列分批执行,遇到拦截或失败自动回补重试,确保采集链路持续稳定,避免数据缺口扩大,适合长期运行的内容库建设项目。
穿云接入流程
1.注册账号
注册穿云API账号,点击 立即注册
注册穿云代理账号,点击 立即注册
穿云账号是互通的,只要注册其一即可,注册后30天内登录后台,点击" 🎁 试用活动 "按钮,领取积分和流量的新手试用礼包。
2.代码生成器
通过代码生成器配置并测试 Cloudflare 或 DataDome 请求。两者共用相同的接入逻辑和代码调用方式,保持代理 IP、Cookie 与会话参数一致。
V1版本自带动态IP池,如可访问,不需要配置IP代理;
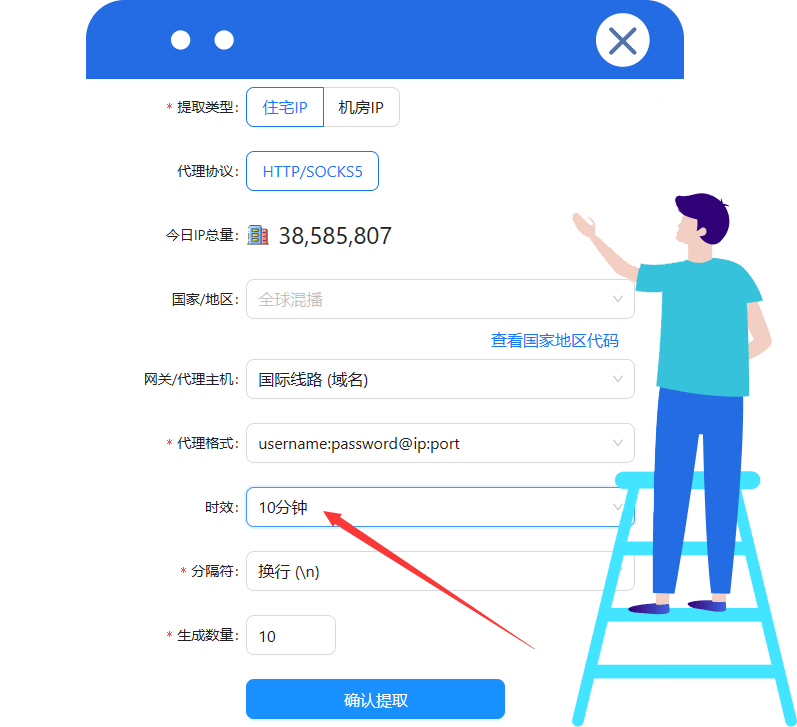
V2(s)版本必须配置固定IP或时效IP,如穿云动态IP需设置10分钟以上时效。(如图)
3.集成穿云API
将测试通过的请求代码集成到现有程序。Cloudflare 与 DataDome 共用相同的 API 接入逻辑和调用方式;检查响应状态与正文后,再继续解析、分页或自动化任务。
4.购买套餐
测试通过后,根据业务用量选择套餐。Cloudflare 与 DataDome 共用同一套 API 积分,采用统一的积分消耗规则和定价策略。查看价格
IP代理流量就购买:【动态机房IP或动态住宅IP】
Cloudflare 与 DataDome 验证处理消耗 API 积分,部分流程需要代理配合。API 积分与代理流量分别计费;代理线路不能代替验证码处理。

穿云API套餐价格
先验证目标兼容性,再按业务用量选择 API 套餐
每次成功请求消耗 1 积分;V2(s) 验证成功额外扣 2 积分,后续响应失败也不退还验证积分。代理流量另计。
基础套餐
-
$49
-
接口积分:80000有效期:30天并发线程:20次/s
标准套餐
-
$79
-
接口积分:300000有效期:30天并发线程:20次/s
高级套餐
-
$129
-
接口积分:1000000有效期:30天并发线程:25次/s
专业套餐
-
$259
-
接口积分:2200000有效期:30天并发线程:25次/s
高阶套餐
-
$489
-
接口积分:4600000有效期:30天并发线程:30次/s
-
极具性价比
至尊套餐
-
$1056
-
接口积分:12000000有效期:30天并发线程:30次/s
FAQ常见问题
新闻/小说内容资讯数据采集为什么经常卡在Cloudflare验证?
资讯与小说站点常启用 Cloudflare 五秒盾、JS Challenge、Turnstile 等防护,对高频、批量访问更敏感,容易触发验证与拦截,导致采集链路中断。
穿云API能处理哪些Cloudflare验证类型?
支持绕过 Cloudflare 五秒盾(JS Challenge)与 Turnstile 等验证场景,自动完成解锁流程并返回可解析的页面内容,减少脚本端复杂适配。
接入穿云API后,采集结果返回什么格式?
请求成功后通常直接返回目标页面源码(HTML),便于你在后端进行正文抽取、章节解析、去重与入库处理。
做高并发的新闻/小说内容资讯数据采集,稳定性如何保障?
穿云API面向批量采集提供并发能力支持,减少验证带来的失败波动;建议配合任务队列、失败重试与增量策略,保证长期运行的更新连续性。
采集小说章节更新时,如何避免漏采或重复?
推荐以“章节序号/更新时间”为增量依据,并记录断点位置;当出现拦截或失败时按队列回补重试,确保目录-章节链路完整,减少数据空洞。
穿云API适合哪些内容资讯采集链路?
适用于栏目列表、专题页、正文详情页、目录页、章节分页与更新列表等结构化采集链路,尤其适合存在 Cloudflare 防护导致的验证跳转与频控问题场景。